


LexunIA es la herramienta GEO que ha desarrollado Jorge Sánchez Mosquete, especialista en SEO y GEO para Netbulb, sirve para responder a una pregunta que las herramientas de seguimiento habituales no contestan o están en Beta:
¿La IA te recomienda cuando nadie te nombra?
La herramienta GEO envía preguntas a once asistentes de IA, guarda cada respuesta íntegra, la analiza, la contrasta con la información oficial de tu marca y devuelve un informe con un plan de acción para dominar el sector. En este artículo queremos explicar qué mide, cómo lo mide, qué produce y qué límites tiene.
¿Qué es LexunIA y qué problema resuelve?
Hay dos preguntas que se confunden constantemente en la conversación sobre IA generativa:
- ¿Te reconoce la IA? La pregunta llega con tu nombre dentro.
- ¿Te elige la IA? La pregunta no te nombra y el asistente tiene que decidirte.
La segunda es la que decide la compra y es la que ningún panel de posiciones SEO mide con precisión, porque mide posiciones, dónde estás en una lista de diez enlaces. Ahora bien, en el canal generativo no hay lista, pero hay una respuesta redactada, con tres o cuatro fuentes y, si tienes suerte, un enlace.
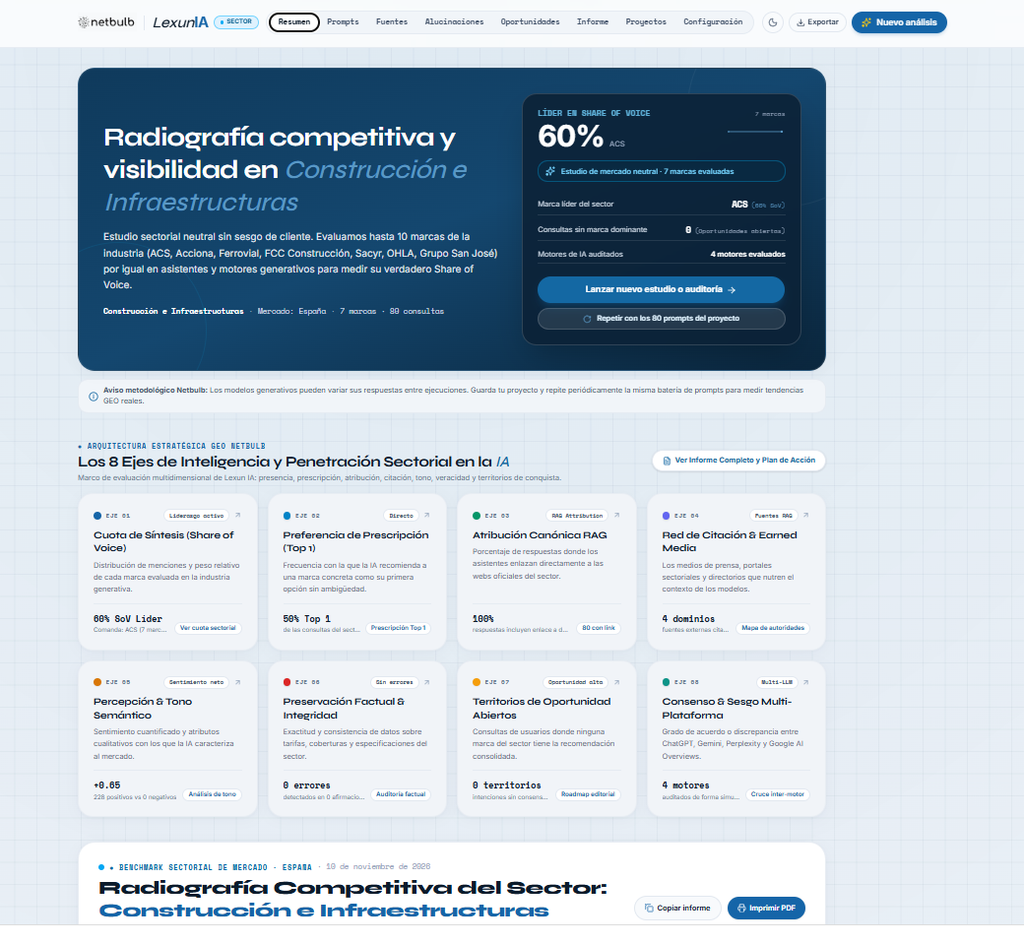
8 ejes de evaluación · 11 motores de IA · 2 modos de análisis
LexunIA by netbulb, existe para medir esa segunda pregunta con la misma exigencia con la que medimos el SEO con consultas reproducibles, con denominadores explícitos, con intervalos de confianza y con la posibilidad de repetir la medición para comprobar si un cambio es real.
La herramienta la hemos desarrolado con dos versiones:
- Auditoría de marca. Esto es para medir a nuestros clientes o empresas de interés para saber cómo le ven, qué dicen de ellos, si les enlazan, qué se inventan y qué temas te estás dejando de lado e interesa trabajar..
- Estudio sectorial multimarca. La idea de este punto es analizar un mercado, entre dos y diez marcas de la misma industria, evaluadas por igual, sin sesgo de marca y que actualmente podrás ver en nuestra sección de informes:
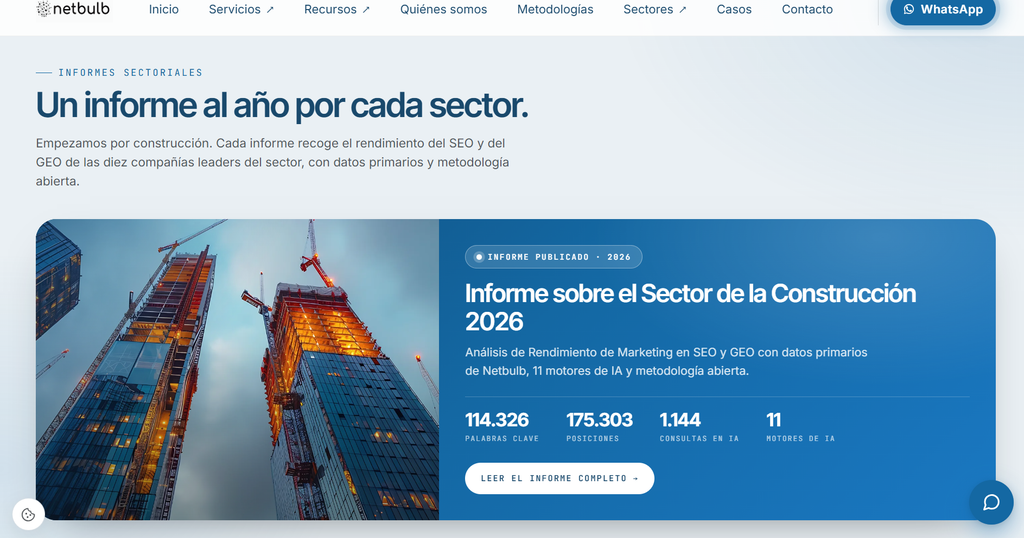
*Este informe se estáctualizando con nuevos barridos para ser lo más exacto posible
¿Cómo trabajamos con esta herramienta Geo?
Paso 1 · Parámetros, competencia y motores
Analizamos la marca, su dominio web, el sector, el mercado y el idioma. Añadimos hasta diez competidores directos con el dominio de nuestra empresa, que es lo que permite que el benchmark sea un benchmark y no una lista decorativa.
El tamaño de la batería de consultas solemos hacerlo entre 25, 50 o 100 y en paralelo seleccionas los motores de IA que queremos auditar, noralmente establecemos los once disponibles por defecto.
Paso 2 · Revisión de prompts y selección de motores
Las consultas se generan automáticamente, pero revisamos a mano antes de lanzar nada, y esa revisión es parte del método por o que solemos añadir otro tipo de consulta si vemos que es de interés donde el generador o al agregar las pregutnas se hace por medio de tres tipos y cuatro fases del recorrido de compra:
| Tipo de consulta | Qué pregunta | Qué revela |
|---|---|---|
Sin marca | Busca una solución sin nombrar a ninguna empresa | Si apareces por mérito propio |
Con marca | Pregunta directamente por ti | Si te reconoce y qué dice de ti |
Marca vs Competidor | Te pone frente a un rival | Si te gana en la comparación |
Y la otra sección para elegir es:
| Fase de compra | Pregunta típica |
|---|---|
| Descubrimiento | ¿Qué empresa de alarmas me recomiendas para un bajo comercial? |
| Consideración | ¿Qué cobertura y qué condiciones tiene cada una? |
| Decisión | ¿Cuánto cuesta contratar y qué permanencia hay? |
| Postcompra | ¿Cómo es el servicio técnico y las garantías? |
Por defecto la clasificación la genera un modelo y, si un tipo o una fase no se reconocen correctamente, el sistema lo reasigna al valor por defecto. Una batería mal clasificada sesga los denominadores de todas las métricas posteriores. Por eso es necesario revisar esta pantalla para no cometer herrores o si se agrega, se debe aplicar con cautela.
Paso 3 · Ejecución multimotor en tiempo real
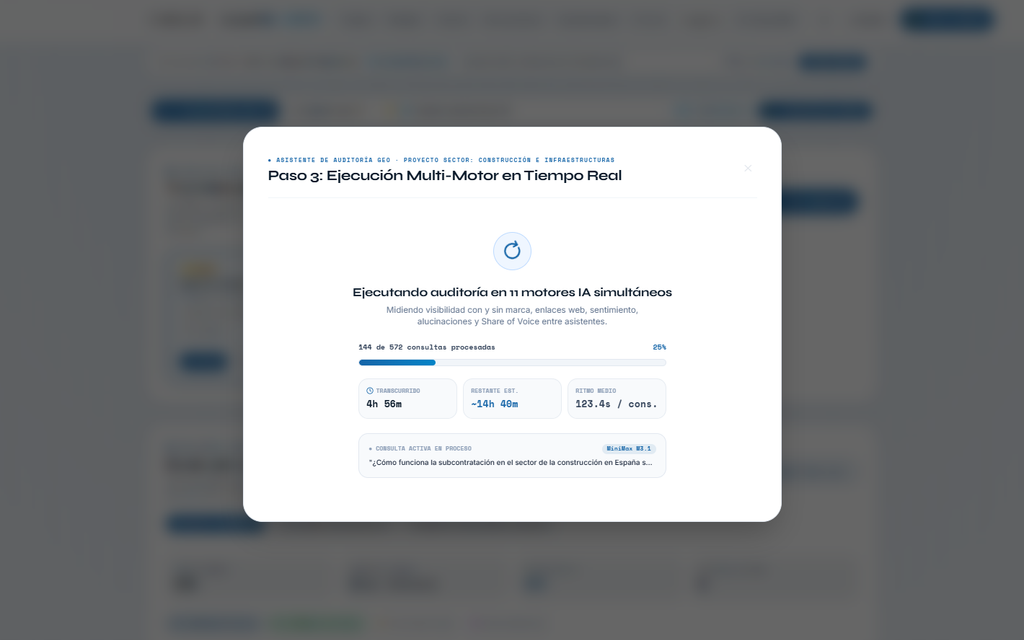
Cada consulta se lanza a cada motor seleccionado, con cinco ejecuciones en paralelo, reintentos por fallo y registro del tiempo de respuesta. De cada respuesta se extraen doce campos como si se menciona la marca, en qué posición aparece, si enlaza a tu dominio, qué competidores se mencionan, cuál se recomienda, el sentimiento con su puntuación, los atributos con los que te describen, los argumentos frente a la competencia, las fuentes citadas, las afirmaciones verificables y los temas cubiertos.
Al terminar, cada ejecución queda guardada con su fecha, su duración y su motor. Eso es lo que permite repetir la misma batería más adelante y comparar: no hay forma honesta de distinguir un cambio real de una variación del modelo si no repites la misma pregunta.
Las ocho pestañas de la herramienta
LexunIA se recorre desde una barra de ocho secciones, y cada una resuelve una parte del encargo:
| Pestaña | Qué resuelve |
|---|---|
| Resumen | Veredicto, Índice GEO, los 8 ejes, gráficos de comparativa, laboratorio predictivo y analítica avanzada |
| Prompts | Todas las consultas con su respuesta íntegra, el motor, los filtros por tipo, fase, mención y motor |
| Fuentes | El ecosistema de citación y earned media, con el plan de menciones priorizado |
| Alucinaciones | La auditoría de exactitud factual, con el contraste contra tu documentación oficial |
| Oportunidades | Los territorios de oportunidad con su blueprint editorial y el prompt maestro de redacción |
| Informe | El informe completo con los 14 apartados y el plan de acción a 60 días |
| Proyectos | Marcas y estudios sectoriales guardados, con su historial de auditorías |
| Configuración | Información oficial de contraste y motores, con su clave y su estado |
Los 8 ejes de evaluación
La pantalla de resumen abre con el veredicto, el Índice GEO y los cuatro indicadores principales. Debajo, la arquitectura de evaluación: 8 ejes, no seis. Cada eje responde a una pregunta y produce una decisión.
Eje 01 · Penetración espontánea (sin marca)
Qué porcentaje de consultas en las que el usuario no te nombra terminan con tu marca en la respuesta. Es el eje que más se parece al comprador real y el más difícil de falsear.
En paralelo se calcula la visibilidad con marca, la comparativa frente a rival y la brecha: la diferencia entre lo que te reconocen y lo que te eligen. La brecha tiene un solo signo, y eso es intencionado. Una marca que aparece más sin ser nombrada que siendo nombrada no tiene un problema de reconocimiento: tiene un problema de posicionamiento. Su categoría ya está asociada a ella.
El informe acompaña la cifra con un intervalo de certeza de Wilson al 90 % (P5–P95). Con 25 consultas, un 40 % de visibilidad no significa 40 %: significa un rango. Sin el rango, la cifra engaña.
Eje 02 · Preferencia de prescripción (Top 1)
Con qué frecuencia los motores te colocan en el primer puesto de sus recomendaciones. En el benchmark por empresa y en el modo sectorial es una medición directa. En la tarjeta del eje se muestra como estimación orientativa a partir de la penetración espontánea, y conviene saber cuál de las dos cosas estás leyendo.
Eje 03 · Atribución canónica RAG
El porcentaje de respuestas que incluyen un enlace a tu web frente a las que solo te nombran de pasada.
El denominador importa: se calcula sobre las respuestas en las que tu marca aparece, no sobre el total. Si te nombran 20 veces y te enlazan 2, tienes un 10 % de atribución, no un 2 %. Es la distancia entre ser una referencia y ser un enlace, y la mención de marca sin enlace es el estado más habitual en casi todos los sectores.
Eje 04 · Red de citación y earned media
El mapa de los dominios que los asistentes usan como grounding, clasificados por tipo (medio, directorio, web de marca, web de competidor, foro, otro) y con la URL de ejemplo de cada uno.
Cada fuente recibe una prioridad (alta, media, baja), una acción de digital PR y la táctica GEO que explica por qué ese tipo de fuente influye en los modelos. Este eje se convierte en una estrategia de presencia digital exportable, y es la parte del análisis que menos se parece al SEO clásico: el modelo no cita tu web, cita el documento que puede recuperar. La lógica está en el RAG y en el grounding.
Eje 05 · Percepción y atributos de marca
El tono con el que la IA te presenta, los atributos con los que te califica y los argumentos que usa frente a la competencia. Se agrega en tres bloques (positivo, neutro, negativo) con una puntuación continua entre −1 y +1, y cada tarjeta es clicable para ver exactamente qué consultas hay detrás de cada bloque.
Eje 06 · Preservación factual e integridad
Cada respuesta se contrasta con la información oficial que tú introduces (servicios, precios, coberturas, condiciones, garantías) y se extraen afirmaciones concretas que se clasifican en tres estados: correcta, incorrecta o no verificable.
La herramienta aplica un protocolo de rigor metodológico que está escrito de forma explícita en la interfaz: nunca marca como incorrecta una afirmación si tu documentación oficial no la desmiente expresamente. En ausencia de datos concretos, la cataloga como no verificable. Es la diferencia entre una auditoría y una máquina de fabricar falsos positivos, y el problema de las alucinaciones en modelos de lenguaje no se resuelve exagerando su detección.
Las discrepancias detectadas se pueden marcar como subsanadas, y el informe recalcula al instante. Cada una se clasifica además en tres niveles de severidad: pérdida de venta, confusión de marca o matiz de catálogo.
Eje 07 · Territorios de oportunidad abiertos
El eje que convierte el diagnóstico en calendario editorial. Identifica las intenciones de búsqueda donde la competencia es citada y tu marca todavía no aparece, y para cada territorio entrega:
- Prioridad (alta, media, baja) calculada por rango, no por volumen bruto.
- Título, intención de búsqueda y formato recomendado.
- Estructura H1/H2/H3 con objetivo GEO por sección (bloque de respuesta directa, comparativa, metodología, FAQ).
- Dos tablas HTML comparativas y tres piezas visuales sugeridas.
- Enlazado interno y las fuentes de autoridad a referenciar.
- Un prompt maestro de redacción listo para pegar en tu modelo.
El roadmap completo, con todos los prompts, se exporta en un clic. La lógica de detección está documentada en keyword gap y en topic modeling.
Eje 08 · Consenso y sesgo multi-plataforma
El grado de acuerdo o discrepancia entre ChatGPT, Gemini, Perplexity y AI Overviews en su prescripción de tu marca. No todos los asistentes tratan igual a tu empresa, y esa diferencia es una decisión de posicionamiento, no un detalle estadístico.
El benchmark multiempresa o el índice GEO de cada empresa
Esta es la pieza nueva del informe. Antes de la auditoría, tu marca competía contra un número: tu visibilidad. Ahora compite contra un ranking, con un índice propio calculado para tu empresa y para cada competidor, con la misma fórmula y los mismos datos.
El motor calcula un perfil analítico por empresa con nueve dimensiones: índice GEO y calificación, menciones totales, visibilidad espontánea, visibilidad general, cuota de voz, tasa de recomendación #1, posición media, tasa de enlace y desglose de sentimiento con sus porcentajes.
El Índice GEO por empresa (0–100) se compone de cuatro bloques:
| Componente | Peso | Qué mide |
|---|---|---|
| Visibilidad espontánea | 40 % | Menciones en consultas donde no te nombran |
| Tasa Top 1 | 22 % | Veces que eres la recomendación principal |
| Sentimiento normalizado | 20 % | Puntuación media reescalada a 0–100 |
| Tasa de enlace | 18 % | Menciones que incluyen enlace a tu dominio |
Con calificación por letra: A+ desde 80, A desde 65, B desde 48, C desde 30 y D por debajo.
El ranking resultante se muestra en la tabla maestra del informe con nueve columnas: posición, empresa y dominio, Índice GEO, visibilidad sin marca, cuota de voz, tasa Top 1, posición media, enlace web y brecha con el líder. La brecha se expresa en puntos de índice, y quien lidera aparece marcado como tal.
Un detalle que merece atención: la cuota de voz no entra en la fórmula del índice. Se reporta como columna informativa. Es una decisión deliberada. La cuota de voz premia estar presente; el índice premia ser elegido. Una marca puede tener mucha presencia y no ganar ninguna recomendación, y ese hueco es justamente donde se pierde la venta.
Qué dice la IA sobre cada empresa
El informe añade un apartado completo de sentimiento y argumentos por empresa, no solo para tu marca.
Para cada empresa analizada —tu marca y cada competidor— el sistema presenta:
- Distribución de sentimiento en porcentaje positivo, neutro y negativo, con la puntuación media sobre 1.
- Fortalezas y atributos clave destacados por la IA, con literales literales de las respuestas.
- Objeciones o debilidades señaladas por los asistentes.
- Qué argumenta la IA al recomendar o comparar esa empresa.
Las fortalezas y las objeciones de los competidores no salen de una opinion: se extraen de las frases de la respuesta que mencionan a esa empresa, con un análisis léxico sobre el texto real. Es decir, si la IA dice que una empresa es cara, lenta o tiene mala cobertura, esa frase aparece en el informe con su contexto.
Esto convierte el benchmark en un argumento de venta y de contenido: no solo te dice dónde estás, te dice qué dice el mercado de ti y de tus rivales, con las palabras exactas que usan los modelos.
Laboratorio de modelos predictivos
El bloque más reciente de la herramienta. Tres vistas conmutables, calculadas en tiempo real sobre los datos reales de la auditoría, sin ninguna métrica simulada.
Proyección temporal
Regresión lineal sobre las auditorías históricas del proyecto, con proyección de la visibilidad espontánea a 30, 60 y 90 días y cono de confianza al 90 %.
Aquí no hay trampa ni relleno: la proyección exige dos o más auditorías del mismo proyecto. Con una sola, la herramienta lo dice de forma explícita y ofrece en su lugar tres indicadores reales de inercia algorítmica con los datos actuales:
| Indicador | Qué mide |
|---|---|
| Intervalo de certeza Wilson (90 %) | El rango real de tu visibilidad, no un punto |
| Índice de retención RAG | Combinación de atribución con enlace, visibilidad espontánea y sentimiento |
| Estabilidad inter-motor | El grado de acuerdo entre los asistentes |
Divergencia de motores
La matriz de concordancia entre asistentes: consenso global (el porcentaje de consultas ejecutadas en dos o más motores donde todos coinciden), índice de polarización (la desviación típica de tu visibilidad entre motores) y el desvío de cada motor frente a la media.
El diagnóstico final se escribe en prosa: dónde alcanza tu marca su mayor cuota espontánea y dónde está su punto ciego.
Preparación para IA (5 pilares)
Un índice de preparación técnica y semántica para asistentes generativos, sobre 100, con calificación A a D:
| Pilar | Qué evalúa |
|---|---|
| Atribución RAG y rastreo | La tasa con la que los motores citan tu dominio como fuente verificable |
| Claridad de entidad | Si los asistentes reconocen tu propuesta de valor sin confundirla con la competencia |
| Red de citación externa | La diversidad de medios, comparadores y directorios que te alimentan |
| Percepción y tono | Si el encuadre algorítmico es favorable, neutral o desfavorable |
| Veracidad factual | La ausencia de discrepancias sobre tarifas, cobertura o servicios reales |
Cada pilar lleva su etiqueta y su navegación directa a la pestaña donde se corrige: optimizar fuentes, verificar discrepancias o atacar los territorios de oportunidad.
Los 11 motores de IA actuales
Ahoramismo trabajamos con una batería específica de IA para ejecutarse en once motores específicos:
| Motor | Búsqueda en vivo | Modelo por defecto |
|---|---|---|
| Google Gemini | No | gemini-3.5-flash-lite |
| Google AI Overview | Sí (SERP) | gemini-3.5-flash-lite |
| ChatGPT / OpenAI | No | openai/gpt-4o-mini |
| Claude / Anthropic | No | anthropic/claude-haiku-5.5 |
| Perplexity Sonar | Sí | perplexity/sonar |
| MiniMax | No | MiniMax-M3.1-Flash |
| DeepSeek | No | deepseek/deepseek-v4.1-flash |
| Meta Llama 3.3 70B | No | meta-llama/llama-3.3-70b-instruct |
| Mistral Large | No | mistralai/mistral-large-4-0 |
| Qwen | No | qwen/qwen3.8-flash |
| Modelos open source | No | Pool Nemotron / Gemma / Liquid LFM |
Cada motor se reporta por separado con su visibilidad, su tasa de enlace, su sentimiento medio y su rival preferido. La respuesta a «¿en qué motor me recomienda la IA?» deja de ser una impresión.
Los motores con búsqueda en vivo (Perplexity Sonar y el modo AI Overview) dan el grounding real, con las URLs que el motor recupera en ese momento. Los modelos sin búsqueda dan la respuesta del modelo acquired, que no está atado a una fecha. Son dos datos distintos y se analizan por separado.
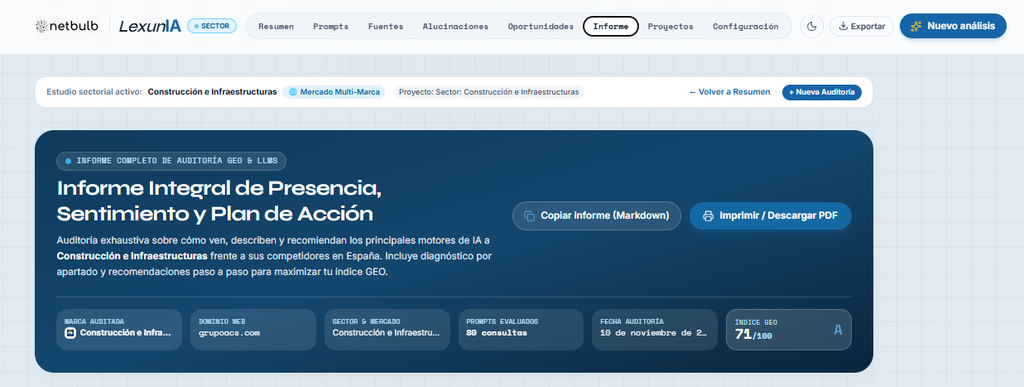
Benchmark de mercado sin marca
El segundo modo no es una opción secundaria. En lugar de auditar tu empresa, defines sector, mercado, idioma, número de consultas y entre dos y diez marcas del sector. La herramienta no pregunta cuál es la tuya: evalúa a todas por igual.
El resultado tiene cuatro piezas:
- Cuota de síntesis (share of voice) de cada marca sobre las respuestas que mencionan alguna de las marcas auditadas.
- Preferencia de prescripción, con el porcentaje de consultas en las que cada marca es la recomendación principal sin ambigüedad.
- Matriz de presencia por motor, con el porcentaje de presencia de cada marca en cada asistente.
- Radar de cinco ejes (visibilidad, recomendación #1, sentimiento, citación con enlace y cobertura de motores) sobre las cuatro marcas líderes.
Y la clasificación que ningún panel de marca te da: cada consulta se etiqueta como monopolio (una sola marca acapara la respuesta), disputada (compiten dos o más) o sin consenso (ninguna marca del sector tiene la recomendación consolidada).
Las consultas sin marca consolidada son el terreno libre. El modo sectorial las convierte en territorios de oportunidad con prioridad alta, y el dashboard lo dice con todas las letras: son la mayor oportunidad de posicionamiento disponible en ese mercado.
El dossier ejecutivo en PDF
El informe imprimible es ahora un dossier numerado de siete secciones con cabecera de auditoría oficial:
- Diagnóstico ejecutivo global, con el veredicto y los cuatro indicadores clave.
- Ranking de Índice GEO y benchmark competitivo de todas las empresas, con la tabla completa y la brecha con el líder.
- Sentimiento de marca y argumentos de la IA por cada empresa, con fortalezas, objeciones y el argumento de recomendación.
- Rendimiento desglosado por motor de IA, con la tasa de enlace y el competidor más recomendado en cada motor.
- Ecosistema de fuentes citadas (RAG).
- Discrepancias críticas detectadas frente a la información oficial, solo si las hay.
- Plan de acción priorizado para maximizar el Índice GEO, con cuatro frentes: respuestas directas TL;DR de 45 a 60 palabras, tablas comparativas estructuradas en HTML, neutralización de objeciones y contradicciones, y siembra en medios satélite y directorios.
El dossier se genera con el diseño de marca y previamente es revisable antes de entregarse al cliente.
El Informe de nuestra herramienta GEO, en pantalla, va más allá y trae catorce apartados que empiezan por el diagnóstico ejecutivo global y el marco metodológico, siguen por la visibilidad de marca, el sentimiento por empresa, el rendimiento por motor, el ranking multi-empresa, las fuentes, los territorios de oportunidad, las discrepancias, el rigor estadístico, la cuota de modelo, la atribución canónica, la matriz competitiva y el protocolo técnico de optimización, y terminan con un plan de acción a 60 días en tres fases para trabajar el impacto en visibilidad comercial, digital PR y citación externa en grounding, y consolidación semántica con repetición de auditoría.
Qué es el Índice GEO y cuál de los dos es el bueno
Conviene ser claro, porque hay dos índices distintos en pantalla y se parecen mucho.
El índice global de tu marca, el que aparece en la cabecera del informe y en el dossier, resume la auditoría completa. Pesa cinco bloques: la visibilidad espontánea sin marca, la visibilidad comparativa frente a rival, el sentimiento normalizado, la atribución con enlace y la salud factual. Se acompaña de una calificación de A+ a D y de un veredicto en prosa que dice, literalmente, si la marca sufre una brecha severa en descubrimiento o si tiene un reconocimiento sólido.
El índice por empresa del ranking usa cuatro bloques (visibilidad espontánea, tasa Top 1, sentimiento normalizado y tasa de enlace) y se calcula con la misma fórmula para tu marca y para cada competidor. Es el que genera la tabla maestra y la columna de brecha con el líder.
La diferencia entre ambos no es un descuido: uno evalúa la auditoría en su conjunto y el otro ordena el mercado. Por eso la cuota de voz aparece como columna informativa en el ranking y no entra en la fórmula del índice. La cuota de voz premia estar presente; el índice premia ser elegido. Una marca puede tener mucha presencia y no ganar ninguna recomendación, y ese hueco es justo donde se pierde la venta.
Proyectos, historial y repetición
Cada marca es un proyecto. Un proyecto guarda la configuración, la batería de consultas, el historial completo de ejecuciones con fecha, duración y motor, y el estado de las discrepancias que has marcado como subsanadas.
Desde ahí sale lo más útil a medio plazo para repetir la auditoría con la misma batería. El botón está en la pestaña de Proyectos y es el mecanismo que convierte la herramienta en un sistema de measurement en el tiempo en lugar de una foto fija.
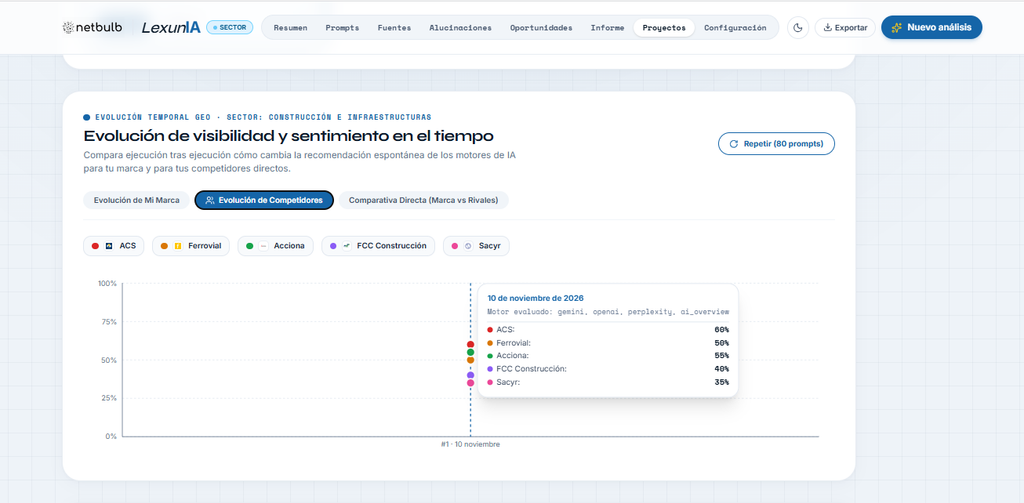
El historial también es lo que alimenta la proyección temporal. Sin dos auditorías comparables, no hay regresión que valga.
* Los modelos generativos varían entre ejecuciones, lo que introduce ruido difícil de distinguir de un cambio real de tendencia.
Qué puedes hacer a partir de aquí
- Pedir una auditoría. Si lo que quieres es que lo ejecutemos sobre tu marca, escríbenos y lo hacemos con una auditoría de visibilidad en asistentes o con una consultoría SEO senior.
- Encargar un estudio sectorial. El modo multi-marca con hasta diez empresas de tu industria está publicado en estudios de mercado GEO.
- Ver el servicio completo. El servicio de GEO y su versión aplicada en Generative Engine Optimization cubren la parte estratégica que hay detrás de la medición.
- Revisar el método. La terminología está documentada en el diccionario de marketing, con entradas específicas para la cuota de voz generativa, la monitorización de menciones en LLMs, el testing de prompts y respuestas y la medición de mención.
Preguntas frecuentes
¿Cuántas consultas necesito para que el resultado sea fiable?
Con 25 consultas ya tienes una lectura con intervalo de confianza publicable que suele ser relativamente rápida. En cambio, con 50 o 100 preguntas, el intervalo se estrecha y aparecen diferencias entre motores que con muestras pequeñas no se ven. Pero la media que solemos trabajar para darnos una idea es trabajar con 50 consultas en 11 motores IA que se conviernten en unas 550 llamadas.
¿Se puede auditar marcas que no sean clientes?
Claro, y para eso hemos creado la versión modo sectorial donde podemos comparar las diez marcas más importantes o que queramos analizar de la misma industria evaluadas por igual, con cuota de síntesis, preferencia de prescripción, matriz de presencia por motor, radar y la clasificación de las consultas sin marca consolidada. Para una marca concreta, el modo de marca da un detalle más específico.
¿Qué diferencia hay entre el Índice GEO de mi marca y el de cada empresa del ranking?
El índice de tu marca, en la cabecera del informe, es la nota global de la auditoría y pesa la visibilidad espontánea, la comparativa frente a rival, el sentimiento, la atribución con enlace como la salud factual. El índice por empresa del ranking usa cuatro bloques (visibilidad espontánea, tasa Top 1, sentimiento y tasa de enlace) y se calcula con la misma fórmula para tu marca y para cada competidor. El primero resume la auditoría, el segundo ordena el mercado y la cuota de voz se reporta aparte, en columna, sin entrar en la fórmula.
¿Los motores sin búsqueda en vivo sirven de algo?
Sí, pero miden otra cosa. Perplexity Sonar y el modo AI Overview consultan la web en el momento y te dan el grounding real, con las URLs que el motor recupera. Los modelos sin búsqueda te dan la respuesta del modelo acquired, que no está atado a una fecha. Ambos datos son útiles y se analizan por separado.
¿La herramienta detecta por sí sola lo que la IA dice mal de mi marca?
Extrae las afirmaciones verificables de cada respuesta y las contrasta con la documentación oficial que tú aportas. Lo que no puede hacer es adivinar tu información oficial, por eso, si no introducimos precios, coberturas y condiciones, todo lo que no esté en ese texto se marcará como no verificable.
¿La proyección temporal necesita muchos datos?
Solamente necesitamos dos auditorías del mismo proyecto. que suele durar varios días. La herramienta no fabrica una curva con un solo punto y con una sola ejecución muestra un estado vacío honesto y tres indicadores reales de inercia algorítmica calculados con los datos disponibles.
¿Cada cuánto conviene repetir la auditoría?
Cada trimestre, y siempre después de un cambio de contenido relevante. La razón no es de marketing sino estadística porque la varianza entre ejecuciones de un mismo modelo es alta, y sin repetir la batería no se puede distinguir un cambio real de ruido.
¿Quién puede usar LexunIA?
Netbulb suele ofrecer bastantes herramientas gratuitas y que puedes acceder en nuestros recursos, pero LexunIA es una herramienta creada por Jorge para trabajar internamente en Netbulb. La usamos en cada auditoría de GEO que entregamos y en los estudios sectoriales que publicamos, reforzado siempre con el crawler HTTPS Ilimitado, Mapa Topológico, Elasticidad TGS Real y Monte Carlo que se encuetra de forma gratuita en nuestro Índice de volatilidad SERP.
Si te parece interesante y quieres que la ejecutemos sobre tu marca, solicita nuestra auditoría de visibilidad en asistentes.
¿Y los bots de IA que rastrean mi web?
El rastreo lo puedes controlar con robots.txt y con las directivas por bot que documentamos en rastreo por bots de IA. La lista de rastreadores, con lo que hace cada uno, está en AI crawler.
Autor de la herramienta LexunIA Brand Visibility con GEO by Jorge Sánchez Mosquete Consultor SEO y especialista en IA generativa. CEO de Netbulb
*Metodología, fórmulas de cálculo, pesos de los índices e intervalos elaborados según critero y cuando una cifra no se puede medir, se publica la limitación en lugar de la cifra.

