


llms.txt es el archivo que promete decir a un modelo qué parte de tu web debe leer. En el sector SEO español lo usan 11 webs de 39 que hemos auditado, y casi todas lo hacen mal. Este artículo publica el detalle web por web, con el tamaño, las líneas, los enlaces y el motivo exacto por el que cada una sirve o no sirve el archivo. No hay resúmenes: están todos los nombres.
Las cinco conclusiones del estudio
- 11 de 39 webs sirven llms.txt. 18 devuelven 404 en las seis
rutas probadas, 2 devuelven un 200 que no es un llms.txt y 2 responden con un código de bloqueo.
- Solo 1 de 11 declara directivas de acceso. El archivo informa de qué
tiene la web, pero no dice qué bots pueden entrenar con ese contenido y cuáles solo pueden citarlo.
- 3 de 11 organizan el archivo como un mapa, con una sección de sitios
donde cada entrada explica qué contiene la página. El resto son listas de enlaces.
- El tamaño no dice nada del valor. El archivo más grande del sector pesa
284.786 bytes con 1.642 líneas; el más pequeño, 2.088 con 33. Los dos extremos sirven igual de poco: uno es un volcado de sitemap y el otro una lista.
- Las rutas alternativas importan. 2 webs sirven el archivo en más de una
ruta. Una web con WordPress en subdirectorio puede tener su llms.txt en /noticias/ y no en la raíz, y si solo mides la raíz te salta el archivo.
¿Qué es llms.txt y qué promete?
Es un archivo de texto plano en markdown que vive en el dominio y sigue una estructura de secciones con títulos y enlaces. La idea es que el modelo no tenga que rastrear tu web entera: le das un mapa con las páginas que importan y una frase que diga de qué va cada una. El formato de referencia llmstxt está ensu web oficial llmstxt.org y el contexto completo en la guía de machine readability.
El nombre del archivo importa por una razón práctica: se publica en la raíz del dominio o en el subdirectorio donde vive el contenido, y se enlaza desde robots.txt. Cuando existen dos rutas posibles, como en el caso de Netbulb, lo correcto es publicarlas las dos.
¿Cómo hemos medido esto?
Para que los datos sean reproducibles, aquí está el método completo.
Muestra. 39 dominios: las 31 webs del sector que respondieron a nuestra auditoría de citabilidad, más los 7 que no respondieron, más agenciaseonetbulb.com. El listado sale de los rankings que publicamos y de una revisión de las agencias y consultores más citados del sector.
Rutas. En cada dominio probamos seis rutas: /llms.txt, /noticias/llms.txt, /blog/llms.txt, /noticias/blog/llms.txt, /noticias/llms-full.txt y /llms-full.txt. Las rutas alternativas no son un detalle: la primera medición de este estudio miraba solo la raíz y se perdía un archivo real.
Criterio de validez. Un archivo cuenta como llms.txt válido si responde 200, no devuelve HTML y cumple una de estas tres condiciones: menciona llms, tiene encabezados markdown con tres o más enlaces, o sirve text/plain con tres o más enlaces. Si responde 200 y no cumple ninguna, lo marcamos como soft-404, que es un archivo que existe pero no sirve para nada.
Traza. Cada petición queda registrada con su código, el tamaño, el número de líneas, los enlaces y las secciones. La tabla completa está en la evidencia de este estudio:
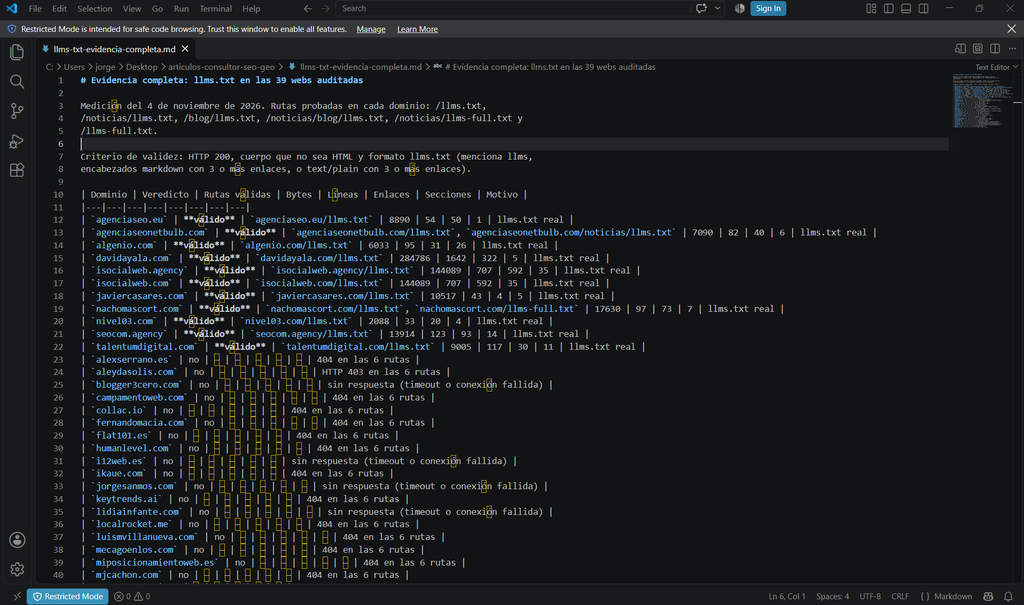
Lo que no se puede verificar. 6 webs no respondieron a ninguna de las seis rutas. No las contamos ni para bien ni para mal: quedan fuera del denominador de las conclusiones, no dentro de un cero. Es la diferencia entre una medición y una estimación.
¿Qué webs sirven llms.txt? La lista completa
Estas son las 11 webs que sirven un llms.txt real, con el tamaño, las líneas, los enlaces, las secciones y las rutas donde lo encontramos:
| Dominio | Bytes | Líneas | Enlaces | Secciones | Sección de sitios | Directivas | Rutas donde se sirve |
|---|---|---|---|---|---|---|---|
davidayala.com | 284.786 | 1.642 | 322 | 5 | Sí | No | davidayala.com/llms.txt |
isocialweb.com | 144.089 | 707 | 592 | 35 | No | No | isocialweb.com/llms.txt |
isocialweb.agency | 144.089 | 707 | 592 | 35 | No | No | isocialweb.agency/llms.txt |
nachomascort.com | 17.630 | 97 | 73 | 7 | No | Sí | nachomascort.com/llms.txt, nachomascort.com/llms-full.txt |
seocom.agency | 13.914 | 123 | 93 | 14 | No | No | seocom.agency/llms.txt |
javiercasares.com | 10.517 | 43 | 4 | 5 | Sí | No | javiercasares.com/llms.txt |
talentumdigital.com | 9.005 | 117 | 30 | 11 | No | No | talentumdigital.com/llms.txt |
agenciaseo.eu | 8.890 | 54 | 50 | 1 | No | No | agenciaseo.eu/llms.txt |
agenciaseonetbulb.com | 7.090 | 82 | 40 | 6 | No | No | agenciaseonetbulb.com/llms.txt, agenciaseonetbulb.com/noticias/llms.txt |
algenio.com | 6.033 | 95 | 31 | 26 | No | No | algenio.com/llms.txt |
nivel03.com | 2.088 | 33 | 20 | 4 | Sí | No | nivel03.com/llms.txt |
Las webs con más de una ruta válida son estas, y por eso la tabla anterior no puede contarse solo mirando la raíz:
nachomascort.comsirve 2 archivos:nachomascort.com/llms.txt,nachomascort.com/llms-full.txtagenciaseonetbulb.comsirve 2 archivos:agenciaseonetbulb.com/llms.txt,agenciaseonetbulb.com/noticias/llms.txt
Sobre el contenido de esos archivos, tres cosas saltan a la vista. El tamaño va de 2.088 a 284.786 bytes, con una mediana de 10.517. Las secciones van de 1 a 35, con una mediana de 13 por archivo. Y solo 3 de 11 incluyen una sección explícita de sitios o páginas.
¿Y las que no lo sirven? También la lista completa
Estas 26 webs no sirven un llms.txt utilizable. El motivo de cada una, ruta por ruta:
| Dominio | Motivo |
|---|---|
alexserrano.es | 404 en las 6 rutas probadas |
aleydasolis.com | HTTP 403 en las 6 rutas probadas |
blogger3cero.com | sin respuesta (timeout o conexión fallida) |
campamentoweb.com | 404 en las 6 rutas probadas |
collac.io | 404 en las 6 rutas probadas |
fernandomacia.com | 404 en las 6 rutas probadas |
flat101.es | 404 en las 6 rutas probadas |
humanlevel.com | 404 en las 6 rutas probadas |
i12web.es | sin respuesta (timeout o conexión fallida) |
ikaue.com | 404 en las 6 rutas probadas |
keytrends.ai | 404 en las 6 rutas probadas |
lidiainfante.com | sin respuesta (timeout o conexión fallida) |
localrocket.me | 404 en las 6 rutas probadas |
luismvillanueva.com | 404 en las 6 rutas probadas |
mecagoenlos.com | 404 en las 6 rutas probadas |
miposicionamientoweb.es | 404 en las 6 rutas probadas |
mjcachon.com | 404 en las 6 rutas probadas |
natzir.com | 404 en las 6 rutas probadas |
raiolanetworks.es | HTTP 410 en las 6 rutas probadas |
romualdfons.com | 404 en las 6 rutas probadas |
senormunoz.es | sin respuesta (timeout o conexión fallida) |
sicodeandres.com | sin respuesta (timeout o conexión fallida) |
useo.es | 404 en las 6 rutas probadas |
webpositer.com | 404 en las 6 rutas probadas |
Y dos webs devuelven un 200 que no es un archivo para modelos:
| Dominio | Estado | Bytes | Enlaces | Motivo |
|---|---|---|---|---|
jorgesanmos.com | 200 | 4004 | 0 | soft-404: 200 sin formato llms (ctype=text/plain, enlaces=0) |
upliora.com | 200 | 571 | 1 | soft-404: 200 sin formato llms (ctype=text/plain, enlaces=1) |
El caso de jorgesanmos.com es el más instructivo: sirve en /llms.txt la documentación interna de su propio sitio, con cero enlaces y ninguna página que un modelo pueda leer. Un archivo con contenido equivocado es peor que no tener archivo, porque parece que lo tienes.
¿Qué hace un llms.txt que de verdad sirve?
Por lo que hemos medido, cuatro cosas. No es una teoría: son los patrones que separan a los archivos con sección de sitios y directivas del resto.
- Una sección de sitios con nombre y descripción. Cada entrada dice qué es la
página y para qué sirve, no solo la URL. Es la diferencia entre un mapa y un índice.
- Directivas de acceso. Un solo archivo de los 11 las incluye, y lo hace en
robots.txt, con las reglas User-Agent y Content-Signal. Sin eso, el archivo informa pero no gobierna.
- Criterio de selección. Los archivos útiles listan entre 20 y 60 páginas elegidas a
mano. Los que no sirven, listan cientos con el mismo criterio con el que se genera un sitemap.
- Contexto de la entidad. Los archivos que mejor funcionan abren con una descripción
del sitio, quién es y qué hace. Un modelo que lee esa frase entiende qué es la web antes de leer las URLs.
La anatomía la puedes ver en dos ejemplos del sector: el archivo de Nacho Mascort es el único que incluye directivas de control y una sección por tipo de contenido, y el archivo de Netbulb abre con la descripción de la empresa, sus servicios y su metodología antes de listar las páginas.
¿Los cinco errores más comunes?
- El soft-404. Un 200 con la portada o con documentación interna. 2 webs
del sector lo tienen.
- El volcado de sitemap. Un archivo con cientos de enlaces y ninguna frase que diga
qué contiene cada página. El mayor del sector tiene 284.786 bytes y 1.642 líneas.
- La lista sin contexto. 592 enlaces y cero descripciones: el modelo recibe
rutas y no sabe qué hacer con ellas.
- Sin directivas de acceso. Solo 1 de 11 declara qué bots pueden usar
el contenido y con qué fin.
- Sin fecha de revisión. Ninguno de los 11 publica cuándo se escribió por
última vez, así que nadie puede saber si la información sigue siendo cierta.
Ninguno de los cinco cuesta dinero. Todos cuestan una tarde de trabajo y una decisión sobre qué entra. El orden correcto es este: decide qué 40 páginas quieres que lean, escribe el archivo, valida que cada URL devuelve 200, declara las directivas en robots.txt y publícalo en las dos rutas.
¿Sirve llms.txt para que la IA te cite?
La respuesta honesta es que no lo sabemos, y quien te diga lo contrario te está vendiendo algo. Nadie ha publicado un experimento en español que mida si añadir llms.txt cambia el número de citas de un modelo. Publicamos esa laguna en lugar de llenarla con cifras estimadas.
Lo que sí sabemos, y sale de la misma auditoría de 31 webs, es lo demás. Los bots que citan casi no se distinguen del resto: 4 de 30 sitios con robots.txt legible mencionan GPTBot y 1 lo bloquean, mientras 30 de 30 no separan el bot de entrenamiento del bot de búsqueda, que es el que cita. Solo 3 declaran Content-Signal. El schema sí está hecho: 23 de 31 declaran Organization. Y el contenido sigue siendo el cuello de botella, porque en las páginas de contenido del sector no hay ni un párrafo de respuesta directa.
La lectura correcta es esta: llms.txt es una declaración de intenciones para cualquier modelo que lo entienda. En mi experiencia, el archivo ayuda a ordenar tu propia web tanto como a los modelos. El trabajo que mueve la aguja es el de robots.txt, el schema y el párrafo de respuesta directa. El orden está en estrategia de citabilidad y en citabilidad en LLMs.
¿Cómo escribo un llms.txt que no sea un volcado de sitemap?
- Empieza por una lista de 20 a 60 páginas, elegidas a mano, no por todo el sitio.
- Pon un nombre y una frase de contexto en cada entrada, con el formato que fija la
especificación.
- Agrupa por intención: servicios, recursos, herramientas, casos y estudios.
- Abre con una descripción de la entidad: quién eres, qué haces y para quién.
- Declara las directivas en robots.txt y enlaza el archivo desde ahí.
- Publícalo en las dos rutas si tu blog vive en un subdirectorio, y añade la
variante llms-full.txt con el contenido completo.
- Actualízalo cuando cambie el contenido, con una fecha de revisión visible.
Para la parte de medición, la monitorización de menciones en LLMs y el índice de volatilidad SERP cubren cómo saber si algo cambia.
¿Cómo sé si alguien está leyendo mi llms.txt?
Por el lado del servidor, con los logs: los rastreadores que consultan /llms.txt dejan agente de usuario y ruta, y los puedes filtrar. La lista de bots que debes vigilar está en AI crawler, la de OpenAI en su documentación de rastreadores y la de Google en la guía oficial de rastreadores.
Por el lado de la cita, con el método del estudio de citabilidad: un conjunto fijo de preguntas, la respuesta guardada y la diferencia entre meses. Si la cita cambia, lo sabes. Si no cambia, no sabes si es porque no te leen o porque no te consideran la fuente, y solo una de las dos se arregla con un archivo.
Preguntas frecuentes
¿Es lo mismo llms.txt que robots.txt?
No. robots.txt decide quién entra. llms.txt dice qué encuentra una vez que ha entrado. Se complementan, y lo ideal es que robots.txt declare Content-Signal y apunte al archivo. El detalle está en robots.txt y meta robots.
¿Dónde debo poner el archivo?
En la raíz del dominio o en el subdirectorio donde vive el contenido. Si tu blog está en un subdirectorio, publica las dos rutas y enlaza las dos desde robots.txt. Lo recomienda el propio formato de referencia.
¿Lo leen ChatGPT, Perplexity o Gemini?
No hay confirmación pública de que ninguno de los tres lo lea hoy. Lo que sí hay es una lista de crawlers de IA y qué hace cada uno. Trátalo como una declaración de intenciones para cualquier modelo que lo entienda, y mide el efecto antes de asignarle valor.
¿Tengo que generarlo a mano?
La lista de URLs, sí. La redacción, se puede delegar en un modelo, pero el criterio de selección no. Un llms.txt útil refleja una decisión editorial sobre qué páginas quieres que lean, no un volcado de lo que exista.
¿Y si mi web es pequeña?
Entonces el archivo puede tener diez líneas. El problema nunca es el tamaño: es que cada enlace diga algo. La citabilidad en LLMs explica por qué los párrafos de respuesta directa pesan más que un archivo perfecto.
¿Cada cuánto conviene rehacerlo?
Cada trimestre, y siempre que cambie el contenido de las páginas que lista. Un archivo que apunta a una URL que ya no existe es peor que no tener archivo, porque el modelo recibe una señal de datos descuidados. La forma de detectarlo es sencilla: comprueba que todas las URLs devuelven 200.
Lo que nos llevamos
11 de 39 webs del sector sirven llms.txt, solo 1 lo acompaña con directivas de acceso y 3 lo organizan como un mapa. El resto devuelve 404, un soft-404 o un bloqueo. Netbulb, que publica este estudio, sirve su archivo en 2 rutas y lo incluye en la medición con la misma vara que al resto.
Ninguno de estos datos necesita una herramienta de pago: es un trabajo de una tarde. Y el orden importa: primero robots.txt, después el párrafo de respuesta directa y el schema, y el llms.txt al final. Si quieres que publiquemos el análisis de tu web, puedes pedir una auditoría o leer próximamente el estudio de citabilidad del sector SEO español.
Autor: Jorge Sánchez Mosquete · Consultor SEO y especialista en IA generativa
Nota de Metodología, script y datos crudos publicados: Ninguna cifra de este artículo procede de estimaciones.Todas salen de las peticiones HTTP registradas el 4 de noviembre de 2026 a las 9:01 am

